Durante os primeiros anos da inteligência artificial generativa, existia uma arquitetura quase invisível para o usuário.
Você escrevia uma pergunta no computador.
A resposta parecia surgir naquela tela.
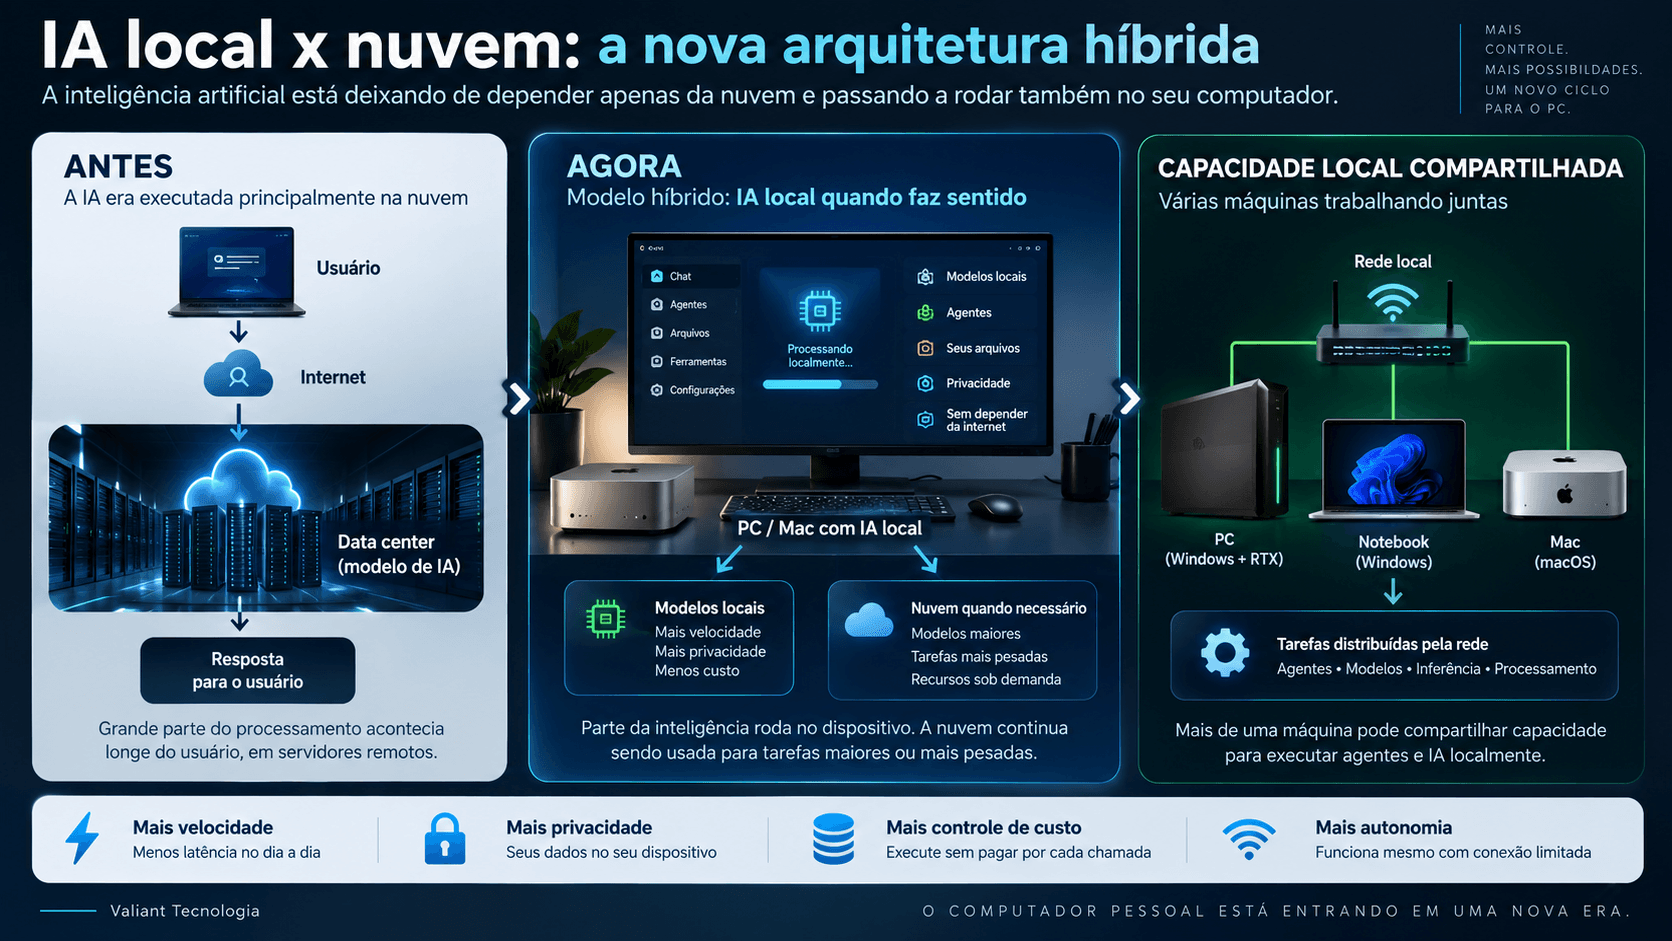
Mas o trabalho pesado acontecia muito longe dali.
Em data centers.
Servidores equipados com GPUs recebiam o pedido, executavam o modelo e enviavam o resultado pela internet.
Agora a indústria começa a empurrar parte dessa inteligência de volta para a máquina que está na sua mesa.
Na IFA 2026, a NVIDIA apresentou novos computadores RTX Spark, ferramentas para executar agentes localmente e até um sistema capaz de combinar a capacidade de vários PCs dentro de uma mesma rede doméstica.
Poucos dias antes, a Apple havia apresentado novos Macs destacando justamente a capacidade de executar modelos grandes diretamente no aparelho.
Esses anúncios apontam para uma mudança importante.
O próximo ciclo do computador pessoal pode ser definido não apenas pelo que ele consegue abrir ou renderizar, mas pela quantidade de inteligência artificial que consegue executar sozinho.
A nuvem não vai desaparecer
Antes de qualquer coisa, é importante deixar isso claro.
Executar IA localmente não significa o fim dos grandes data centers.
Modelos gigantescos continuarão exigindo infraestrutura enorme.
Treinamentos avançados continuarão dependendo de clusters com milhares de aceleradores.
E serviços de IA continuarão utilizando nuvem para entregar capacidades que não cabem num notebook.
A mudança é outra.
Uma parcela cada vez maior das tarefas poderá ser executada no próprio dispositivo.
Isso cria uma arquitetura híbrida:
IA local quando faz sentido.
IA na nuvem quando é necessária.
Por que executar IA no próprio computador?
Existem quatro vantagens principais.
Resposta mais rápida
Quando um modelo está no próprio computador, não é necessário enviar todo pedido pela internet.
Isso pode reduzir latência.
Privacidade
Dados podem permanecer no aparelho.
Um documento, fotografia, projeto ou código não precisa necessariamente sair da máquina para ser processado.
Custo
Serviços de IA na nuvem costumam consumir recursos medidos por uso, tokens ou assinatura.
Depois que o hardware local foi adquirido, determinados modelos podem ser executados repetidamente sem pagar por cada chamada externa.
Disponibilidade
Algumas tarefas podem continuar funcionando mesmo sem conexão constante.
Essas vantagens ajudam a explicar por que fabricantes estão investindo tão agressivamente em IA local.
NVIDIA quer transformar o PC em máquina para agentes
A NVIDIA apresentou na IFA uma nova geração de computadores baseados em RTX Spark.
Segundo a empresa, os primeiros sistemas Windows chegam em outubro.
Entre os fabricantes anunciados estão Lenovo e Acer, além de outros parceiros preparando equipamentos.
A ideia da NVIDIA é bastante clara:
não vender apenas um PC mais rápido.
Vender uma máquina preparada para:
- jogos;
- criação;
- desenvolvimento;
- modelos de IA;
- agentes executados continuamente.
O computador deixa de ser apenas uma ferramenta utilizada diretamente por uma pessoa.
Pode começar a executar tarefas em segundo plano por conta própria.
O que é RTX Spark?
RTX Spark é uma nova plataforma computacional da NVIDIA para PCs.
Ela combina:
- CPU Grace;
- GPU baseada na arquitetura Blackwell;
- memória unificada;
- recursos específicos para IA.
A configuração mais poderosa anunciada pela NVIDIA oferece:
- até 20 núcleos de CPU;
- até 128 GB de memória unificada;
- GPU com capacidade declarada de até 1 petaflop para cargas de IA.
Mais importante do que o número isolado é a combinação.
Modelos de IA modernos precisam de bastante memória.
Não basta possuir processamento rápido.
O modelo inteiro — ou grande parte dele — precisa caber na memória disponível.
É por isso que a capacidade de memória começa a se tornar um dos principais argumentos dos computadores voltados para IA.
Memória virou uma especificação de IA
Durante muitos anos, usuários comparavam computadores principalmente por:
- CPU;
- GPU;
- armazenamento.
Com IA local, outra pergunta ganha importância:
quanto do modelo cabe na memória?
Modelos maiores podem exigir dezenas ou centenas de gigabytes.
Quando o modelo não cabe, é necessário:
- utilizar versões menores;
- reduzir precisão;
- dividir processamento;
- recorrer à nuvem.
É por isso que máquinas com 64 GB, 128 GB ou mais de memória começam a ocupar um espaço diferente.
Elas não são apenas computadores com “muita RAM”.
Podem executar classes de modelos que máquinas menores simplesmente não conseguem manter localmente.
A Apple já está fazendo a mesma aposta
Poucos dias antes do anúncio da NVIDIA, a Apple apresentou novos Mac mini e Mac Studio com forte ênfase em IA executada no próprio aparelho.
O Mac Studio com M5 Ultra pode chegar a 512 GB de memória unificada.
Segundo a Apple, isso permite executar localmente modelos com centenas de bilhões de parâmetros.
A empresa destacou explicitamente que esses modelos podem funcionar no dispositivo sem necessidade de enviar dados para a nuvem e sem cobrança por tokens.
O Mac mini com M6 também foi apresentado com ganhos importantes de desempenho para IA local.
Isso mostra que Apple e NVIDIA estão chegando ao mesmo problema por arquiteturas diferentes.
A disputa não é simplesmente Windows contra Mac
Seria fácil transformar essa história numa comparação:
RTX versus Apple Silicon.
Mas a mudança maior é outra.
As duas empresas estão reconhecendo que o computador pessoal pode voltar a executar cargas que estavam migrando para servidores remotos.
Durante os últimos anos, muita tecnologia caminhou para a nuvem.
Arquivos.
Aplicações.
Processamento.
Agora a IA cria um movimento parcial na direção oposta.
Parte do processamento volta para o dispositivo.
O motivo é simples: IA consome muito recurso
Cada vez que alguém utiliza um modelo hospedado na nuvem, existe infraestrutura trabalhando.
GPUs.
Servidores.
Energia.
Rede.
Refrigeração.
Esse custo aumenta conforme o uso cresce.
Para tarefas que podem ser realizadas localmente, deslocar processamento para o computador do usuário pode ser economicamente interessante.
A empresa reduz parte do custo de inferência.
O usuário utiliza o hardware que já possui.
Isso não elimina a nuvem.
Mas redistribui o processamento.
O modelo híbrido provavelmente será o mais comum
Imagine um assistente pessoal.
Algumas tarefas poderiam ocorrer localmente:
- organizar arquivos;
- buscar documentos;
- resumir textos;
- transcrever áudio;
- analisar fotografias;
- executar automações;
- consultar informações pessoais.
Outras poderiam subir para a nuvem:
- pesquisa muito extensa;
- modelos extremamente grandes;
- geração avançada de vídeo;
- processamento que exige infraestrutura especializada.
O software poderia escolher automaticamente onde executar cada tarefa.
Essa combinação pode ser mais importante do que a ideia de “IA 100% local”.
NVIDIA também quer facilitar a instalação
Existe outro obstáculo além do hardware.
Rodar modelos localmente ainda costuma exigir conhecimento técnico.
O usuário precisa escolher:
- modelo;
- formato;
- quantização;
- servidor de inferência;
- configuração;
- memória;
- ferramentas.
Isso cria atrito.
A NVIDIA anunciou integrações para simplificar a instalação local em ferramentas como:
- Hermes Agent;
- OpenClaw;
- Perplexity Portable Computer.
O objetivo é aproximar a experiência de algo muito mais simples:
escolher a ferramenta e deixar que o sistema configure o modelo adequado.
Isso é importante porque facilidade vence tecnologia escondida
Uma capacidade pode existir tecnicamente e ainda não se tornar popular.
Para o usuário comum, o processo precisa ser simples.
Poucas pessoas querem passar horas escolhendo quantização ou configurando servidores.
Se agentes locais dependerem permanentemente desse conhecimento, continuarão sendo produtos de nicho.
Por isso a camada de software é tão importante quanto o chip.
O verdadeiro avanço ocorre quando hardware poderoso fica invisível.
NVIDIA também acelerou modelos que já existem
A empresa anunciou otimizações para dois projetos importantes no ecossistema de IA local:
llama.cpp
e
vLLM.
Segundo a NVIDIA, novas otimizações permitem ganhos de até 1,9 vez na inferência local em determinados cenários com GeForce RTX 5090.
Essas melhorias também chegam a aplicações como:
- LM Studio;
- Ollama.
Isso é importante porque LM Studio e Ollama já são duas das maneiras mais populares de executar modelos localmente.
A NVIDIA não está tentando criar todo o ecossistema do zero.
Está tentando acelerar ferramentas que desenvolvedores já utilizam.
O computador também pode começar a trabalhar em grupo
Talvez o anúncio mais curioso da NVIDIA seja o PAIR — Personal AI Router.
A ideia é utilizar capacidade computacional ociosa disponível dentro de uma rede local.
Imagine uma casa com:
- desktop;
- notebook;
- segundo PC;
- Mac.
Normalmente essas máquinas passam boa parte do dia com parte de seu processamento parado.
PAIR permite que tarefas de IA sejam distribuídas entre elas.
Como o PAIR funciona?
O sistema identifica computadores compatíveis na rede local.
Quando um agente divide uma tarefa em vários trabalhos menores, o PAIR pode encaminhar cada parte para uma máquina que tenha capacidade disponível.
Por exemplo:
um agente pode precisar executar cinco análises independentes.
Em vez de colocar todas numa única GPU, o sistema pode distribuir:
tarefa 1 → computador A
tarefa 2 → computador B
tarefa 3 → computador C
e assim por diante.
Quando uma máquina fica ocupada, as tarefas podem ser redirecionadas.
É quase um pequeno cluster doméstico.
E aqui aparece uma surpresa: Macs também entram
Apesar de ser uma ferramenta da NVIDIA, o PAIR não funciona apenas com GPUs NVIDIA.
A versão beta oferece suporte a:
- Windows;
- Linux;
- macOS;
- GeForce RTX 20 ou mais recente;
- RTX PRO;
- DGX Spark;
- Apple Silicon M4 ou mais recente.
Isso torna a conexão entre NVIDIA e Apple particularmente interessante.
Nesse caso, as arquiteturas não precisam necessariamente competir.
Podem trabalhar juntas.
Um PC RTX e um Mac podem participar da mesma infraestrutura local de IA.
Isso muda a ideia de “meu computador”
Tradicionalmente, pensamos em capacidade computacional por máquina.
Meu notebook possui determinada CPU.
Meu desktop possui determinada GPU.
PAIR propõe outra lógica:
qual é a capacidade computacional disponível na minha rede?
Isso transforma vários dispositivos em uma espécie de recurso compartilhado.
Para agentes, isso pode fazer bastante sentido.
Agentes frequentemente quebram tarefas grandes em várias subtarefas.
Essas tarefas podem ser executadas em paralelo.
Quanto mais capacidade estiver disponível, mais rápido o trabalho pode terminar.
É como montar um pequeno data center em casa
Guardadas as proporções, a lógica lembra um data center.
Um data center não depende de uma única máquina gigantesca.
Distribui trabalho entre muitos servidores.
PAIR tenta trazer uma versão muito menor dessa arquitetura para casas e pequenos escritórios.
É uma ideia especialmente interessante para pessoas que já possuem vários computadores potentes.
Em vez de deixar parte desse hardware parado, a IA poderia utilizá-lo.
Mas isso ainda é nicho
É importante não exagerar o alcance atual.
A maioria das pessoas não possui:
- vários PCs de alto desempenho;
- GPUs RTX;
- Mac M4;
- grandes quantidades de memória.
Também não executa agentes complexos localmente.
Portanto, essa primeira geração é claramente direcionada a:
- desenvolvedores;
- criadores;
- pesquisadores;
- entusiastas;
- profissionais que trabalham com IA.
Isso não significa que a tecnologia ficará restrita a esse grupo.
Mas é onde ela começa.
O mesmo aconteceu com outras tecnologias
GPUs começaram como componentes associados principalmente a gráficos e jogos.
Depois passaram a acelerar:
- vídeo;
- ciência;
- renderização;
- IA.
SSDs começaram como equipamentos caros.
Hoje são padrão.
Tecnologias locais de IA podem seguir trajetória semelhante.
Primeiro aparecem em máquinas premium.
Depois são incorporadas em computadores intermediários.
Por fim, deixam de ser percebidas como recurso separado.
O termo “AI PC” finalmente começa a ganhar sentido
A indústria vem utilizando o termo “AI PC” há algum tempo.
Muitas vezes, isso significava pouco mais do que possuir uma NPU e executar alguns recursos de software.
A nova geração começa a justificar melhor o nome.
Um computador realmente orientado para IA precisa conseguir:
- armazenar modelos;
- executar inferência;
- trabalhar continuamente;
- utilizar ferramentas;
- rodar agentes;
- proteger dados locais;
- alternar entre processamento local e nuvem.
Isso é muito mais do que adicionar um botão de IA ao sistema operacional.
Agentes locais podem ser o verdadeiro ponto de virada
Executar um chatbot local é interessante.
Mas executar um agente local pode ser muito mais relevante.
Um chatbot espera uma pergunta.
Um agente pode continuar trabalhando.
Pode:
- analisar arquivos;
- organizar informações;
- monitorar tarefas;
- usar ferramentas;
- executar processos;
- dividir trabalho entre subagentes.
Se isso acontece localmente, o computador começa a assumir uma função diferente.
Ele não apenas responde ao usuário.
Trabalha para ele.
Isso também cria novas questões de segurança
Um agente local possui uma vantagem:
os dados podem permanecer na máquina.
Mas isso não significa risco zero.
Um agente que consegue:
- abrir arquivos;
- acessar email;
- executar código;
- navegar;
- modificar documentos;
também possui poder significativo.
Quanto mais autonomia recebe, maior precisa ser o controle.
Por isso sistemas operacionais terão papel fundamental.
A NVIDIA destaca que RTX Spark será integrado ao Windows Agent Framework, permitindo agentes executados em segundo plano sob controles do sistema operacional.
A próxima disputa não será apenas por desempenho.
Será por como permitir que agentes atuem sem entregar acesso irrestrito ao computador.
IA local também não significa necessariamente mais privacidade
Existe uma diferença entre:
o modelo rodar localmente
e
todo o aplicativo funcionar localmente.
Um programa pode executar o modelo no dispositivo e ainda:
- enviar telemetria;
- acessar serviços online;
- sincronizar arquivos;
- consultar APIs externas.
Portanto, “IA local” não deveria ser tratada automaticamente como sinônimo de privacidade total.
O comportamento depende da aplicação inteira.
Nem sempre local será melhor
Um modelo local também possui limitações.
Pode ser:
- menor;
- menos atualizado;
- mais lento;
- menos capaz;
- limitado pela memória do aparelho.
Modelos de nuvem continuam tendo acesso a infraestrutura muito maior.
Por isso a escolha provavelmente será contextual.
Tarefas simples ou sensíveis:
local.
Tarefas enormes:
nuvem.
O software pode decidir isso automaticamente.
Apple possui uma vantagem importante: integração
A Apple controla:
- hardware;
- sistema operacional;
- chips;
- ferramentas de desenvolvimento;
- frameworks.
Isso facilita otimizar IA para o dispositivo.
Core ML, Metal e as ferramentas de desenvolvimento da empresa conseguem utilizar diretamente CPU, GPU e Neural Engine.
Além disso, Apple Silicon utiliza memória unificada.
Essa arquitetura permite que diferentes componentes acessem grandes blocos de memória compartilhada.
Para modelos de IA, isso pode ser uma vantagem importante.
NVIDIA possui outra vantagem: ecossistema
NVIDIA possui forte presença entre:
- desenvolvedores de IA;
- frameworks;
- CUDA;
- ferramentas de inferência;
- GPUs;
- jogos;
- criação profissional.
RTX Spark tenta trazer esse ecossistema para um novo formato de computador.
A disputa não será apenas:
qual chip é mais rápido?
Também será:
em qual plataforma é mais fácil executar os modelos e agentes que as pessoas realmente querem usar?
E existe uma terceira força: Microsoft
A NVIDIA não está construindo isso sozinha.
Windows também está evoluindo para agentes.
O Windows Agent Framework aparece justamente como camada responsável por permitir que sistemas agentivos funcionem dentro de controles do sistema operacional.
Isso cria uma aliança estratégica importante:
Microsoft controla o Windows.
NVIDIA fornece o hardware e parte da infraestrutura de IA.
fabricantes constroem os PCs.
É uma tentativa de responder à integração vertical da Apple por meio de um ecossistema de parceiros.
O PC volta a ser importante na corrida da IA
Durante os últimos anos, parecia que praticamente toda inovação importante em IA acontecia dentro de grandes data centers.
O dispositivo do usuário funcionava principalmente como janela.
Agora o hardware pessoal volta a ganhar relevância.
Porque executar IA local exige:
- memória;
- processamento;
- eficiência;
- armazenamento;
- software.
Isso cria novamente espaço para diferenciação de computadores.
Talvez a pergunta do consumidor futuro não seja apenas:
“qual é a velocidade deste notebook?”
Pode ser:
“qual agente este computador consegue rodar sozinho?”
Isso pode mudar o ciclo de upgrade
Existe também uma consequência comercial.
Por muitos anos, um computador de cinco anos ainda conseguia executar grande parte das tarefas comuns.
Navegação.
Documentos.
Vídeo.
Comunicação.
Isso reduziu a necessidade de atualização frequente.
IA local pode criar uma nova diferença de geração.
Máquinas novas terão:
- mais memória;
- aceleradores;
- GPUs específicas;
- NPUs;
- suporte a modelos maiores.
Se aplicações começarem a depender dessas capacidades, usuários podem voltar a encontrar razões concretas para trocar hardware.
É por isso que fabricantes estão tão interessados nessa narrativa.
Mas precisamos evitar uma nova corrida de marketing
Nem todo computador rotulado como “AI PC” será automaticamente melhor.
O consumidor precisará olhar para aquilo que realmente importa.
Por exemplo:
- quantidade de memória;
- largura de banda;
- desempenho real em modelos;
- consumo energético;
- ferramentas compatíveis;
- tamanho de modelos suportados;
- autonomia;
- preço.
TOPS isolados ou slogans não contam toda a história.
Assim como megapixels não definem sozinhos uma câmera.
Para quem isso importa hoje?
Principalmente para quem trabalha diretamente com IA.
Desenvolvedores podem testar modelos sem depender tanto de APIs.
Criadores podem gerar imagens e editar conteúdo localmente.
Pesquisadores podem trabalhar com dados sensíveis.
Empresas podem executar determinados modelos internamente.
Entusiastas podem criar seus próprios agentes.
Para o usuário comum, a mudança ainda está começando.
Mas a infraestrutura necessária já está chegando ao mercado.
O computador deixa de ser apenas cliente da nuvem
Talvez essa seja a transformação mais importante.
Durante anos, computadores caminharam para virar terminais cada vez mais dependentes de serviços remotos.
A IA começa a criar um movimento diferente.
O dispositivo volta a executar trabalho pesado.
Só que agora não estamos falando apenas de programas tradicionais.
Estamos falando de modelos capazes de interpretar linguagem, imagens, áudio e executar tarefas.
Isso devolve valor à capacidade computacional local.
A próxima disputa será entre inteligência local e inteligência remota
Apple, NVIDIA, Microsoft e outras empresas estão construindo peças dessa nova arquitetura.
Nenhuma delas parece apostar que tudo será local.
Também não parece provável que tudo permaneça na nuvem.
O futuro mais provável é híbrido.
Seu computador terá uma inteligência local.
A nuvem terá modelos ainda maiores.
E o software decidirá quando utilizar cada uma.
Quando isso estiver bem implementado, talvez o usuário nem perceba onde o processamento aconteceu.
Perceberá apenas que a tarefa foi realizada.
E aí o computador muda de função
O PC tradicional espera você abrir um programa.
O próximo PC pode manter agentes trabalhando enquanto você faz outra coisa.
Ele poderá:
- organizar;
- resumir;
- pesquisar;
- gerar;
- comparar;
- monitorar;
- executar.
Parte disso localmente.
Parte na nuvem.
Parte distribuída entre várias máquinas.
O anúncio da NVIDIA na IFA é importante justamente porque mostra que essa ideia está deixando o laboratório e começando a virar produto.
Os computadores RTX Spark chegam em outubro.
Novos Macs já estão sendo vendidos com IA local como argumento central.
PAIR transforma várias máquinas em uma pequena rede de computação.
E agentes começam a ganhar integração direta com o sistema operacional.
Durante anos, a inteligência parecia estar indo para a nuvem.
Agora parte dela está voltando para a mesa.
E talvez o próximo grande salto do computador pessoal não seja uma tela melhor, um processador um pouco mais rápido ou uma bateria maior.
Talvez seja algo muito mais profundo:
um computador capaz de trabalhar sozinho — sem precisar pedir tudo para um servidor do outro lado da internet.
O método é o protagonista. A ferramenta é o veículo.
Valiant Tecnologia — promovendo evolução consciente.

