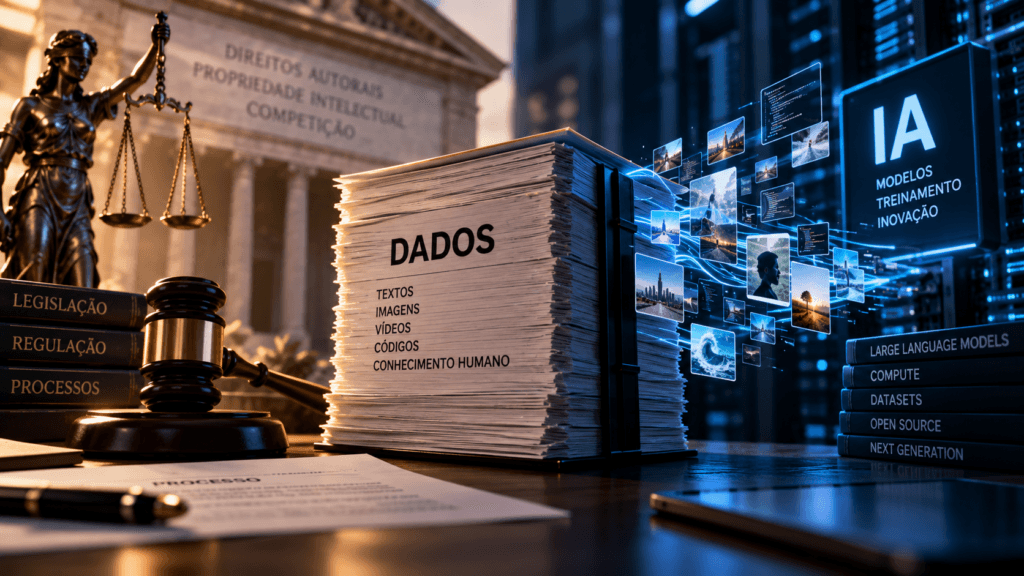
Para construir inteligência artificial em grande escala são necessários pelo menos três recursos difíceis de ignorar:
computação, energia e dados.
Os dois primeiros aparecem constantemente nas discussões sobre IA.
Falamos sobre GPUs, data centers, eletricidade, chips e bilhões de dólares em infraestrutura.
O terceiro recurso parece menos físico, mas pode se tornar igualmente disputado.
Modelos são treinados sobre enormes quantidades de textos, imagens, músicas, vídeos, códigos e outras informações produzidas ao longo de décadas por pessoas, empresas e instituições.
E uma pergunta que durante anos ficou principalmente nos tribunais começa a ganhar dimensão política internacional:
quem pode usar esse conteúdo para treinar inteligência artificial — e quem deve ser pago por isso?
Em setembro de 2026, essa discussão entrou oficialmente na agenda do G20.
O G20 não liberou o treinamento com obras protegidas
Esse ponto precisa ficar claro desde o começo.
O G20 não decidiu que empresas de inteligência artificial podem usar livremente qualquer obra protegida por direitos autorais.
Também não criou uma regra mundial de treinamento de modelos.
O que aconteceu foi diferente.
Em reunião ministerial dedicada à inovação, os países do grupo chegaram a um consenso em torno de seis pilares para tecnologias emergentes.
Um deles trata especificamente de políticas de propriedade intelectual para inteligência artificial.
Isso já é significativo.
O treinamento de IA deixa de aparecer apenas como disputa entre uma empresa e um artista ou entre uma plataforma e um jornal.
Passa a fazer parte de discussões sobre política industrial, competição tecnológica, comércio, inovação e soberania.
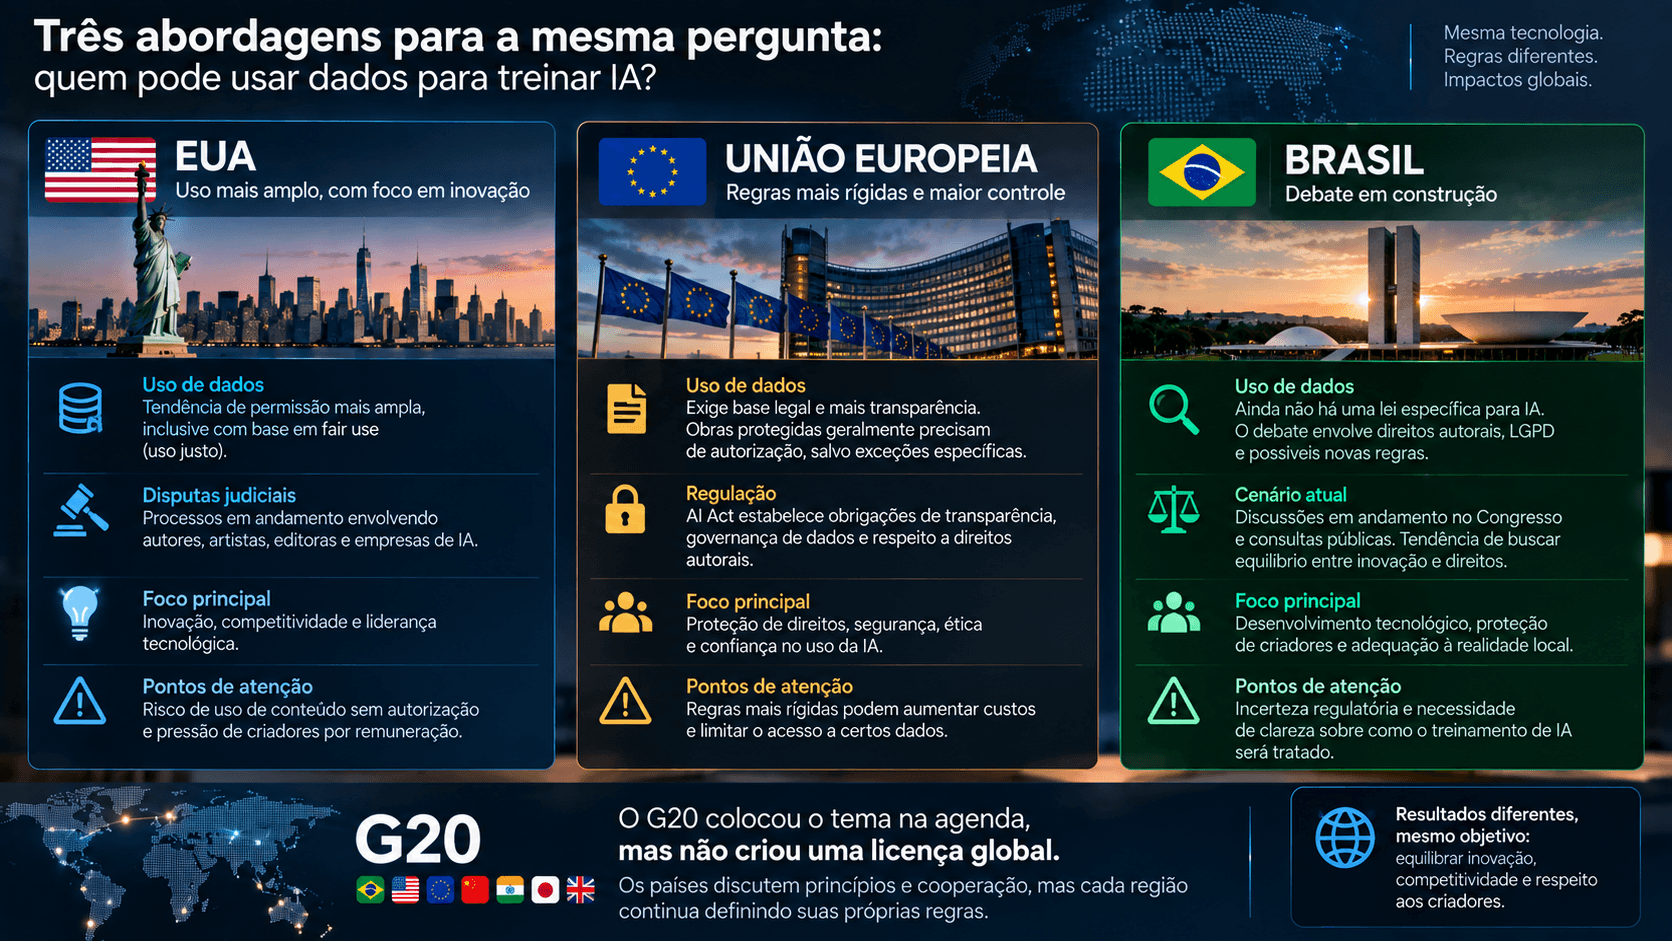
Os Estados Unidos defendem mais espaço para fair use
Durante o encontro, o governo dos Estados Unidos defendeu que países desenvolvam estruturas que permitam a empresas treinar modelos com obras protegidas em situações compatíveis com a doutrina americana de fair use.
Mas fair use não significa “uso livre”.
Nos Estados Unidos, trata-se de uma análise jurídica aplicada caso a caso.
Tribunais consideram fatores como finalidade do uso, natureza da obra, quantidade utilizada e possível impacto sobre o mercado da obra original.
Até dentro dos Estados Unidos não existe uma regra simples afirmando que todo treinamento de IA é fair use.
O próprio U.S. Copyright Office, ao analisar inteligência artificial generativa, reconhece que diferentes formas de treinamento podem receber avaliações jurídicas diferentes.
Copiar obras inteiras pesa em uma direção; finalidade transformativa, impacto econômico e características específicas do uso pesam em outras.
Ao mesmo tempo, a posição americana defendida no encontro do G20 foi mais favorável a preservar espaço para treinamento sob fair use, segundo relato da Reuters.
A disputa está longe de terminar.
Para os criadores, a pergunta é econômica
Do outro lado existe um problema igualmente real.
Um escritor pode passar meses produzindo um livro.
Um fotógrafo pode investir anos construindo um arquivo.
Um jornal mantém equipes para produzir reportagens.
Músicos, ilustradores, cineastas e desenvolvedores criam obras que passam a fazer parte do ambiente informacional usado para desenvolver sistemas de IA.
Se empresas conseguem extrair valor econômico dessa produção sem remuneração ou negociação, surge uma pergunta sobre sustentabilidade:
quem financiará a produção da próxima geração de conteúdo?
Direitos autorais existem justamente porque sociedades decidiram criar incentivos econômicos para a produção cultural e intelectual.
Isso não significa que todo uso de uma obra precise ser pago.
Existem exceções, limitações, domínio público, licenças abertas e diferentes formas de utilização permitida.
Mas treinamento em escala industrial adiciona uma situação que as legislações tradicionais não foram escritas pensando explicitamente.
A União Europeia escolheu outro caminho
A União Europeia oferece um exemplo de abordagem diferente.
Seu regime permite determinadas atividades de text and data mining, ou mineração de texto e dados, inclusive para finalidades comerciais.
Mas titulares podem, em determinadas situações, reservar seus direitos, sinalizando que não autorizam esse tipo de mineração e preferem negociar uma licença.
Isso cria uma lógica distinta da discussão americana.
Em vez de depender exclusivamente de uma análise posterior de fair use nos tribunais, existe um mecanismo formal que permite ao titular declarar que não quer determinada utilização.
O modelo europeu também está desenvolvendo instrumentos para tornar essas reservas de direitos mais identificáveis por sistemas automatizados.
Ainda existem discussões técnicas e jurídicas sobre como isso funciona na prática.
Mas o princípio demonstra algo importante:
não existe hoje uma única solução internacional.
E o Brasil?
No Brasil, a discussão também está aberta.
A Lei de Direitos Autorais, de 1998, determina que diversas formas de utilização de uma obra dependem de autorização do titular, incluindo reprodução e armazenamento em computador, salvo as limitações previstas pela própria legislação.
Essas limitações incluem situações como citações, pequenos trechos para determinados usos e outras exceções específicas.
A lei brasileira, porém, não nasceu pensando em modelos generativos e não possui uma exceção geral explicitamente desenhada para mineração comercial de texto e dados equivalente à existente na União Europeia.
Isso não permite concluir automaticamente que qualquer treinamento de IA sobre material protegido é ilegal no Brasil.
A aplicação concreta da legislação ainda depende de interpretação jurídica, circunstâncias específicas e da evolução regulatória.
E justamente por existir essa incerteza, o Congresso discute novas regras.
Em julho de 2026, por exemplo, foi apresentado um projeto que propõe alterar a Lei de Direitos Autorais para regular economicamente obras utilizadas no treinamento de sistemas de inteligência artificial e instituir direito de remuneração proporcional.
Paralelamente, a discussão sobre direitos autorais também faz parte do debate mais amplo do marco legal brasileiro de inteligência artificial.
O Brasil já sinalizou preocupação com remuneração
A posição brasileira nos fóruns culturais internacionais também não começou agora.
Durante a presidência brasileira do G20, a declaração ministerial de Cultura já destacou a importância de pagamento adequado aos titulares de direitos no ambiente digital e de transparência relacionada a sistemas de inteligência artificial.
O Ministério da Cultura continua tratando proteção de autores e artistas no ambiente de IA como uma área estratégica.
Portanto, quando os Estados Unidos defendem internacionalmente maior espaço para treinamento sob fair use, o Brasil entra no debate carregando outra tradição jurídica e outra preocupação política.
É exatamente por isso que copiar uma solução americana não é simples.
O verdadeiro conflito não é “IA contra artistas”
Reduzir essa discussão a dois lados torna tudo mais difícil de entender.
Empresas de IA precisam de grandes quantidades de dados para desenvolver modelos competitivos.
Pesquisadores precisam de acesso a informação.
Pequenas empresas também podem ser prejudicadas se apenas gigantes tecnológicos conseguirem pagar por grandes acervos.
Ao mesmo tempo, produtores de conteúdo precisam preservar incentivos econômicos e controle sobre suas obras.
Existe ainda outra camada.
Grande parte da internet utilizada para treinar modelos não foi criada por grandes editoras ou estúdios.
Foi produzida por milhões de pessoas:
- blogs;
- fóruns;
- fotografias;
- vídeos;
- código;
- documentação;
- wikis;
- comentários;
- sites independentes.
Criar um sistema de remuneração justo para tudo isso é muito mais complexo do que simplesmente enviar uma conta para uma empresa de IA.
Licenciamento pode ser parte da solução — mas não resolve tudo
Uma possibilidade é ampliar mercados de licenciamento.
Já existem empresas de IA negociando acordos com editoras, veículos de comunicação e detentores de grandes acervos.
Isso cria uma forma direta de remuneração.
Mas o modelo também apresenta problemas.
Grandes titulares possuem poder para negociar.
Um criador individual quase nunca possui a mesma capacidade.
Além disso, exigir licença individual para bilhões de documentos poderia tornar determinadas formas de pesquisa e desenvolvimento economicamente inviáveis.
Por isso aparecem propostas como:
- licenciamento coletivo;
- remuneração proporcional;
- reservas de direitos;
- opt-out;
- transparência sobre dados de treinamento;
- bases licenciadas;
- mecanismos de negociação entre plataformas e entidades representativas.
Nenhuma dessas soluções eliminou completamente o conflito.
Transparência pode ser tão importante quanto dinheiro
Existe uma dificuldade ainda anterior à remuneração.
Para discutir pagamento, o autor precisa saber se sua obra foi utilizada.
Em muitos modelos, essa informação é difícil ou impossível de determinar individualmente.
Por isso, transparência sobre fontes e conjuntos de treinamento começa a ganhar importância regulatória.
Sem algum nível de rastreabilidade, direitos teoricamente existentes podem ser quase impossíveis de exercer.
Mas transparência também possui limites.
Empresas alegam que revelar conjuntos completos pode expor segredos comerciais, facilitar ataques ou tornar públicos dados cuja redistribuição também poderia gerar problemas jurídicos.
A solução provavelmente precisará equilibrar auditabilidade e proteção legítima de informações.
A matéria-prima agora tem preço político
A primeira fase da corrida de inteligência artificial foi marcada por uma pergunta simples:
quem constrói o modelo mais capaz?
A fase seguinte está revelando perguntas menos vistosas.
Quem possui os chips?
Quem controla os data centers?
Quem distribui os modelos?
Quem possui os dados?
Quem pode autorizar seu uso?
E quem recebe quando conteúdo protegido gera valor dentro de uma cadeia comercial de inteligência artificial?
O encontro do G20 não respondeu essas perguntas.
Mas mostrou que elas já não pertencem apenas aos tribunais ou aos departamentos jurídicos das empresas de tecnologia.
Viraram política internacional.
A Valiant também está dos dois lados
Esse conflito não é abstrato para quem produz conteúdo.
Uma operação como a Valiant utiliza sistemas de inteligência artificial para pesquisar, organizar informações e acelerar processos.
Ao mesmo tempo, produz artigos, imagens e vídeos próprios.
Somos usuários da tecnologia e produtores da matéria-prima cultural que tecnologias futuras podem consumir.
Essa posição ajuda a enxergar por que soluções absolutas dificilmente funcionam.
Proibir qualquer forma de análise computacional de conteúdo pode bloquear usos legítimos e inovação.
Permitir qualquer utilização sem transparência, escolha ou remuneração também pode enfraquecer quem financia a produção de informação original.
Esse equilíbrio reforça a importância de usar IA com método, verificação e responsabilidade, inclusive quando a tecnologia trabalha sobre informação produzida por outras pessoas.
O desafio é construir uma estrutura na qual inovação continue possível sem transformar criação humana em recurso economicamente invisível.
A disputa está apenas começando
Estados Unidos, União Europeia e Brasil estão caminhando por modelos diferentes.
Nos Estados Unidos, fair use continuará sendo testado nos tribunais enquanto o governo defende uma interpretação favorável à inovação.
Na União Europeia, mineração de dados convive com mecanismos de reserva de direitos.
No Brasil, a legislação atual está sendo pressionada por uma tecnologia que não existia quando suas principais regras foram escritas, enquanto novas propostas discutem transparência e remuneração.
O G20 não resolveu essa diferença.
Ele apenas colocou o problema formalmente sobre a mesa.
E talvez seja esse o sinal mais importante.
Durante anos tratamos dados como algo praticamente infinito na corrida da inteligência artificial.
Agora estamos descobrindo que parte dessa matéria-prima possui autores, contratos, direitos e valor econômico.
A pergunta já não é apenas quanto custa treinar uma IA.
É também:
quanto vale aquilo que ensinou essa IA a compreender o mundo?
O método é o protagonista. A ferramenta é o veículo.
Valiant Tecnologia — promovendo evolução consciente.
Fontes consultadas
- The White House — G20 Innovation Ministerial Concludes with Consensus Statement
- Reuters — posição americana sobre treinamento de IA e fair use
- U.S. Copyright Office — Copyright and Artificial Intelligence, Part 3
- EUIPO — Copyright and GenAI
- Presidência da República — Lei 9.610/1998
- Câmara dos Deputados — proposta sobre remuneração por treinamento de IA
- Gov.br / G20 — declaração ministerial de Cultura

