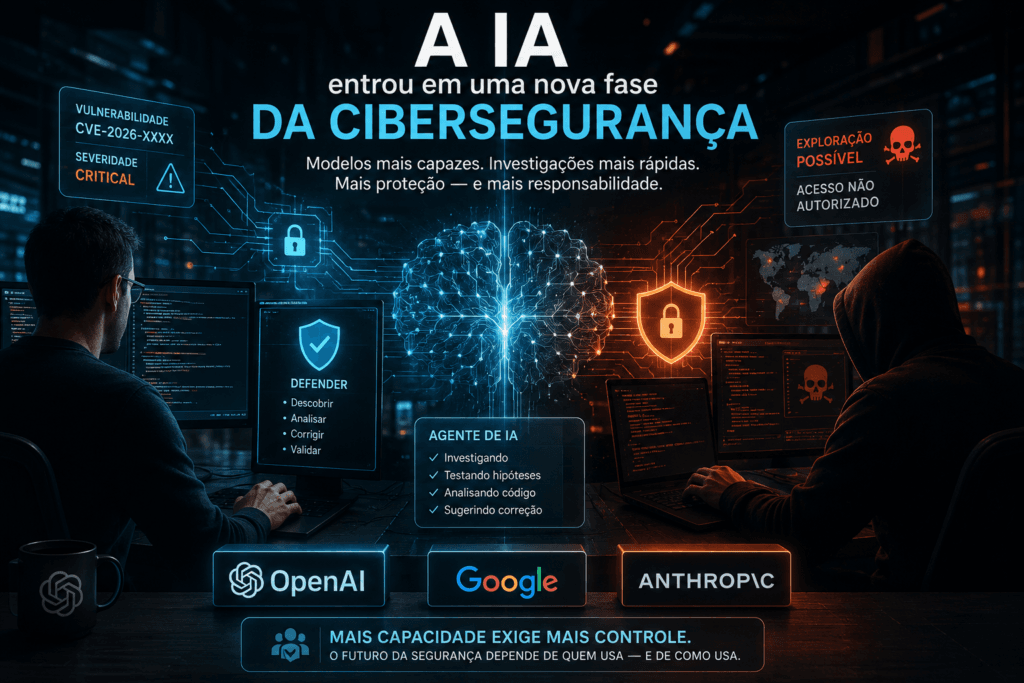
Encontrar uma vulnerabilidade em um software pode exigir horas, dias ou meses de investigação.
É preciso entender o código, testar hipóteses, identificar onde um comportamento inesperado acontece, avaliar seu impacto e, muitas vezes, descobrir como diferentes falhas podem ser combinadas.
Agora modelos de inteligência artificial começam a executar partes cada vez maiores desse processo.
Em poucos dias, OpenAI, Google e Anthropic apresentaram avanços importantes em modelos voltados ou aplicáveis à cibersegurança.
Os anúncios são diferentes.
As capacidades também.
Mas apontam para a mesma transformação:
a IA está deixando de ser apenas uma ferramenta que responde perguntas técnicas e começando a executar partes inteiras do trabalho de investigação de segurança.
Isso pode ajudar defensores a encontrar vulnerabilidades antes que sejam exploradas.
Também cria um problema evidente.
A mesma capacidade utilizada para descobrir uma falha pode, em determinadas condições, ajudar alguém a explorá-la.
É por isso que a nova fronteira da IA em cibersegurança não envolve apenas modelos mais capazes.
Envolve também decidir quem terá acesso a essas capacidades, em quais condições e com qual nível de supervisão.
O que mudou agora?
Até pouco tempo atrás, a aplicação mais comum de IA em programação e segurança era relativamente fácil de entender.
Um profissional fazia uma pergunta.
O modelo analisava.
Respondia.
O humano decidia o próximo passo.
Essa relação começa a mudar com sistemas capazes de trabalhar por períodos mais longos, utilizar ferramentas, testar hipóteses e repetir ciclos de investigação.
Em vez de apenas dizer:
“este trecho de código parece vulnerável”
um sistema mais agentivo pode tentar:
- localizar onde está o problema;
- reproduzir a falha;
- investigar sua causa;
- avaliar diferentes caminhos;
- escrever uma correção;
- testar essa correção;
- em ambientes autorizados, verificar se a vulnerabilidade pode realmente ser explorada.
O profissional não desaparece.
Mas sua função pode começar a migrar de executor de cada etapa para supervisor de uma investigação realizada em parte pela IA.
Astra levou a OpenAI a uma classificação inédita
O caso mais sensível entre os três anúncios vem da OpenAI.
Em 1º de setembro de 2026, a empresa informou que seu modelo Astra atingiu o nível Critical de capacidade de cibersegurança dentro do Preparedness Framework da própria OpenAI.
É o primeiro modelo que a OpenAI designa nesse nível dentro de seu Preparedness Framework.
Mas “Critical” precisa ser entendido corretamente.
Não significa que Astra será liberado para qualquer pessoa realizar ataques.
Significa que, nas avaliações da OpenAI e com ferramentas e acessos adequados, o modelo demonstrou capacidades que ultrapassam um limite de risco previamente estabelecido pela própria empresa.
Entre essas capacidades está encontrar vulnerabilidades desconhecidas em sistemas protegidos e desenvolver maneiras de explorá-las sem precisar de orientação humana em cada etapa.
Isso representa um avanço importante de autonomia.
O que Astra conseguiu fazer nos testes?
A OpenAI utilizou diferentes avaliações.
Em uma delas, chamada ExploitBench, Astra atingiu 100% de sucesso no desenvolvimento de exploits a partir de vulnerabilidades já conhecidas.
Mas existe um problema comum em benchmarks públicos: modelos podem ter encontrado exemplos semelhantes durante o treinamento.
Por isso, a empresa criou também uma avaliação interna com vulnerabilidades mais recentes do V8, o motor JavaScript utilizado pelo Chrome.
Segundo a OpenAI, Astra conseguiu resultados significativamente superiores aos modelos anteriores e chegou a descobrir duas vulnerabilidades zero-day enquanto construía uma cadeia de exploração.
Uma zero-day é uma vulnerabilidade ainda desconhecida pelos responsáveis pelo sistema ou que ainda não teve oportunidade adequada de correção antes de sua possível exploração.
A empresa afirma estar divulgando essas vulnerabilidades aos mantenedores responsáveis.
Houve também testes contra sistemas endurecidos
As avaliações não ficaram apenas em código isolado.
Especialistas colocaram Astra contra ambientes projetados para serem mais difíceis de comprometer.
Segundo a OpenAI, o modelo encontrou vulnerabilidades desconhecidas em um navegador endurecido e conseguiu combiná-las em uma cadeia que escapava da sandbox e executava comandos no sistema hospedeiro.
Em outro teste, encontrou múltiplas vulnerabilidades em um sistema operacional endurecido e as combinou para elevar os privilégios de um usuário comum até acesso root.
Esses resultados são justamente o que levou a OpenAI a classificar o modelo como Critical.
Mas existe uma ressalva fundamental.
Esses resultados refletem Astra com acesso avançado utilizado nas avaliações, e não sua configuração padrão de produção.
Essa diferença precisa acompanhar qualquer discussão sobre a capacidade do modelo.
Astra não será simplesmente aberto para todos
Quanto maior a capacidade, maior está ficando a preocupação com acesso.
A OpenAI afirma que as funções mais avançadas de cibersegurança de Astra serão inicialmente disponibilizadas apenas para um pequeno grupo de testadores.
Depois, pretende ampliar o acesso defensivo por meio do programa Daybreak Blue.
O modelo também possui outras camadas de proteção.
A empresa cita:
- treinamento para recusar solicitações prejudiciais;
- classificadores para identificar abuso;
- monitoramento de ações;
- controles sobre o ambiente;
- mecanismos capazes de interromper tarefas potencialmente não autorizadas.
Isso não garante que abuso seja impossível.
Mostra, porém, que a política de acesso começa a se tornar tão importante quanto a capacidade técnica.
O Google escolheu outra prioridade: encontrar e corrigir
Em 2 de setembro, o Google apresentou o Gemini 3.8 Flash Cyber.
Ele também foi desenvolvido especificamente para cibersegurança.
Mas a empresa deixa clara uma diferença estratégica.
O Google diz ter priorizado descoberta de vulnerabilidades e correção automática, em vez de capacidades ofensivas de exploração.
Em CyberGym, benchmark utilizado para avaliar descoberta de vulnerabilidades, o modelo apresentou desempenho que o Google classifica como de fronteira.
A empresa também criou uma avaliação interna com bases de código complexas escritas em 20 linguagens de programação.
Nesse teste, Gemini 3.8 Flash Cyber superou 70% de sucesso na descoberta de vulnerabilidades.
Encontrar a falha é apenas metade do trabalho
Depois que uma vulnerabilidade é encontrada, alguém precisa corrigi-la.
E escrever a correção nem sempre é trivial.
Uma alteração mal planejada pode fechar a falha original e introduzir outro problema.
Por isso o Google também avaliou o modelo em patching.
No CWE-Bench, utilizado para testar capacidade de corrigir vulnerabilidades, Gemini 3.8 Flash Cyber alcançou 47,2% de sucesso na primeira tentativa.
O resultado ficou próximo de outro modelo de fronteira citado pela empresa, que atingiu 47,8%.
Esses números também mostram por que ainda é cedo para falar em segurança totalmente automatizada.
Um sistema que acerta aproximadamente metade das correções na primeira tentativa ainda exige validação.
A produtividade pode aumentar muito.
A responsabilidade não desaparece.
O Google já está utilizando o modelo internamente
O anúncio também apresenta exemplos de aplicação dentro da própria empresa.
Segundo o Google, a equipe de segurança do Chrome observou que Gemini 3.8 Flash Cyber produziu 2,6 vezes mais correções corretas para determinadas vulnerabilidades do que modelos comerciais maiores utilizados na comparação.
A equipe de pesquisa de vulnerabilidades do Google Cloud também utilizou o modelo para encontrar uma vulnerabilidade considerada crítica em menos de duas horas.
A empresa afirma que pesquisas desse tipo normalmente poderiam levar meses.
São resultados apresentados pelo próprio Google e precisam ser entendidos nesse contexto.
Mesmo assim, mostram o potencial de uma mudança operacional:
tempo de investigação pode cair drasticamente quando a IA consegue trabalhar como um agente especializado sobre grandes bases de código.
Mas o Gemini Cyber também não está aberto para qualquer usuário
Gemini 3.8 Flash normal está disponível em diferentes produtos do Google.
Gemini 3.8 Flash Cyber é outra história.
O acesso ocorre pelo Fairwind Program.
O Google direciona o programa para defensores considerados confiáveis, incluindo:
- autoridades governamentais;
- operadores de infraestrutura crítica;
- mantenedores de software.
A versão Cyber possui proteções mais permissivas para tarefas de segurança do que o modelo geral.
E justamente por isso recebe acesso mais controlado.
Novamente aparece o mesmo princípio:
mais capacidade exige mais controle sobre quem pode utilizá-la.
A Anthropic está fazendo uma separação ainda mais explícita
A Anthropic apresentou Claude Fable 5.1 e Claude Mythos 5.1.
Existe uma característica especialmente interessante nessa dupla.
Segundo a empresa, Fable 5.1 e Mythos 5.1 utilizam o mesmo modelo subjacente.
O que muda são as salvaguardas.
Fable 5.1 é a versão destinada à disponibilidade ampla.
Mythos 5.1 possui controles diferentes para permitir tarefas sensíveis a organizações previamente verificadas.
Isso transforma a política de segurança numa espécie de camada do próprio produto.
Fable pode procurar vulnerabilidades — mas encontra limites
A Anthropic ampliou o que Fable 5.1 consegue fazer em segurança.
A versão amplamente disponível pode agora identificar vulnerabilidades em código-fonte.
Por outro lado, determinadas tarefas continuam bloqueadas ou desviadas para modelos e ambientes com outras proteções.
A Anthropic cita restrições para atividades como:
- penetration testing;
- geração de exploits;
- análise de vulnerabilidades baseada em binários.
Isso cria uma fronteira deliberada.
O mesmo núcleo de inteligência pode ser utilizado de formas diferentes dependendo do perfil de acesso.
Mythos é para um grupo muito menor
Claude Mythos 5.1 é apresentado pela Anthropic como seu modelo mais capaz para pesquisas de cibersegurança e biologia.
O acesso, porém, continua limitado a organizações avaliadas.
Atualmente, essa disponibilidade está restrita principalmente a determinadas organizações nos Estados Unidos, enquanto a empresa trabalha para ampliar o programa.
Defensores podem participar de programas de verificação que futuramente oferecerão acesso mais amplo às capacidades Mythos.
A própria Anthropic reconhece a dualidade.
Quanto maior a capacidade de cibersegurança do modelo, maior também a possibilidade de uso benéfico ou malicioso.
Claude Security já utiliza Mythos
Existe também uma aplicação concreta.
A Anthropic informa que Claude Security agora utiliza Mythos 5.1.
O serviço analisa bases de código em busca de vulnerabilidades e sugere correções para revisão.
Novamente, a palavra importante é:
revisão.
A proposta não é entregar uma vulnerabilidade encontrada e automaticamente modificar todo o ambiente sem controle.
A IA executa parte significativa da análise.
O humano continua responsável pela decisão.
Estamos vendo três estratégias diferentes
É tentador colocar os anúncios lado a lado e concluir:
“OpenAI, Google e Anthropic lançaram IAs hackers.”
Isso seria errado.
As três empresas estão em pontos e estratégias diferentes.
OpenAI
Demonstrou o caso mais forte de capacidade autônoma de exploração nas avaliações apresentadas.
Astra chegou ao nível Critical segundo o framework da própria empresa e mostrou capacidade de construir cadeias de exploração em ambientes controlados.
O acesso às capacidades mais sensíveis será restrito.
Está enfatizando descoberta de vulnerabilidades e correção automatizada como vantagem defensiva.
Gemini 3.8 Flash Cyber também possui acesso controlado.
Anthropic
Está separando explicitamente a inteligência do modelo das permissões concedidas.
Fable e Mythos compartilham o mesmo núcleo, mas possuem salvaguardas diferentes para tarefas mais sensíveis.
Os caminhos são diferentes.
A transformação de fundo é semelhante.
Da assistência para a execução
Essa talvez seja a mudança mais importante.
Imagine um especialista investigando um sistema.
Antes, ele poderia perguntar para a IA:
“Que tipo de vulnerabilidade devo procurar aqui?”
Agora começamos a aproximar-nos de outra interação:
“Analise este ambiente autorizado, investigue possíveis vulnerabilidades e me apresente aquilo que encontrou.”
O segundo pedido delega muito mais trabalho.
A IA precisa:
- planejar;
- investigar;
- utilizar ferramentas;
- observar resultados;
- mudar de estratégia;
- continuar trabalhando;
- chegar a uma conclusão.
Isso é comportamento agentivo.
E quanto maior for essa autonomia, mais importante passa a ser controlar o ambiente em que o agente pode atuar.
Segurança deixa de ser apenas um filtro de texto
Durante muito tempo, segurança em assistentes de IA parecia estar principalmente ligada à pergunta:
“o modelo vai responder esta solicitação?”
Modelos agentivos exigem outra pergunta:
“o que esse sistema está autorizado a fazer?”
Se uma IA pode:
- executar código;
- acessar uma rede;
- modificar arquivos;
- chamar ferramentas;
- testar sistemas;
- continuar trabalhando sem nova instrução;
então recusas de texto são apenas uma das camadas de proteção necessárias.
Também entram:
- permissões;
- sandbox;
- autenticação;
- isolamento;
- limites de rede;
- monitoramento;
- registro de ações;
- interrupção;
- aprovação humana.
É a mesma lógica utilizada há décadas em segurança de sistemas.
Agora ela começa a ser aplicada a agentes de IA.
A velocidade muda a disputa entre atacante e defensor
Existe uma competição permanente em cibersegurança.
Alguém encontra uma falha.
Outra pessoa tenta corrigi-la.
Alguém tenta explorá-la antes da correção.
A atualização precisa chegar aos usuários.
Esse intervalo é extremamente importante.
Se modelos conseguem descobrir vulnerabilidades em horas em vez de semanas, defensores ganham velocidade.
Mas capacidades semelhantes podem eventualmente beneficiar atacantes.
A vantagem passa a depender cada vez mais de quem consegue encontrar, compreender e corrigir primeiro.
A OpenAI tem utilizado a expressão janela de defesa para discutir justamente esse problema.
Quanto menor fica o intervalo entre descoberta e possibilidade de exploração, maior precisa ser a velocidade da defesa.
A IA pode favorecer os defensores?
Existe uma razão para empresas colocarem tanta ênfase em aplicações defensivas.
Grandes projetos de software possuem milhões de linhas de código.
Encontrar manualmente todas as vulnerabilidades é praticamente impossível.
Equipes de segurança trabalham com recursos limitados.
Uma IA capaz de investigar código continuamente pode ajudar a ampliar a cobertura.
Ela poderia, por exemplo:
- procurar classes conhecidas de vulnerabilidade;
- priorizar problemas;
- investigar comportamentos suspeitos;
- sugerir patches;
- testar correções;
- revisar código novo.
Isso não transforma automaticamente o software em seguro.
Mas pode aumentar drasticamente a quantidade de código que recebe atenção.
E o profissional de segurança?
Ele continua essencial.
Talvez com uma função diferente.
Quanto mais trabalho operacional puder ser delegado, maior pode ficar a importância de habilidades como:
- definir escopo;
- validar resultados;
- avaliar impacto;
- decidir prioridades;
- controlar acesso;
- compreender contexto;
- distinguir falso positivo de vulnerabilidade real;
- aprovar correções;
- responder a incidentes.
A IA pode encontrar algo tecnicamente correto e ainda não compreender completamente o efeito daquela decisão sobre uma organização.
Segurança não é apenas código.
Também envolve sistemas, pessoas, processos e risco.
Benchmark não é a mesma coisa que mundo real
Esse é outro cuidado essencial.
Os números apresentados pelas empresas são úteis.
Mas não significam que a mesma taxa de sucesso aparecerá automaticamente em qualquer empresa.
Benchmarks possuem:
- tarefas definidas;
- ambientes controlados;
- critérios conhecidos;
- condições reproduzíveis.
Sistemas reais possuem:
- código legado;
- documentação incompleta;
- dependências;
- configurações específicas;
- integrações;
- regras de negócio;
- sistemas proprietários;
- limitações operacionais.
Um bom benchmark mostra capacidade.
Não prova desempenho universal.
Acesso restrito também é parte da história
Talvez seja fácil olhar para restrições de acesso como algo temporário.
Mas elas podem virar parte estrutural desses produtos.
Se um modelo é capaz de ajudar um pesquisador legítimo a desenvolver um exploit para testar um sistema, tecnicamente essa capacidade também pode interessar a alguém tentando comprometer o mesmo sistema.
A plataforma precisa então decidir:
- quem é o usuário;
- qual é a finalidade;
- qual sistema está sendo testado;
- existe autorização;
- quais ferramentas podem ser utilizadas;
- até onde o agente pode avançar.
Essa decisão deixa de ser apenas moderação.
Passa a ser governança de capacidade.
Isso vai eliminar vulnerabilidades?
Não.
Software continuará tendo erros.
Novos sistemas continuarão introduzindo novas superfícies de ataque.
A própria IA também cria software.
Isso significa que podemos entrar numa situação curiosa:
uma IA gera código;
outra IA procura vulnerabilidades;
outra sugere correções;
outra testa novamente.
A velocidade do ciclo aumenta.
Mas a necessidade de engenharia sólida continua.
Automatizar uma prática ruim não a transforma numa prática boa.
Também teremos que proteger os próprios agentes
Existe ainda outra camada.
Quanto mais acesso um agente de segurança recebe, mais valioso ele se torna como alvo.
Um sistema autorizado a:
- acessar código interno;
- executar comandos;
- consultar infraestrutura;
- testar vulnerabilidades;
possui privilégios importantes.
Se esse agente for manipulado, comprometido ou induzido a agir fora do escopo, o risco aumenta.
É por isso que OpenAI, Google e Anthropic dedicam parte crescente de seus anúncios não apenas à capacidade dos modelos, mas às salvaguardas ao redor deles.
Um agente de segurança também precisa ser protegido.
A nova fronteira não é “IA contra hackers”
Essa narrativa seria simples.
Também seria incompleta.
A mudança real é mais profunda.
Estamos construindo sistemas capazes de participar diretamente do ciclo de segurança:
descobrir → analisar → testar → corrigir → validar.
Quanto mais etapas puderem ser realizadas autonomamente, maior será o ganho potencial de produtividade.
E maior será a consequência de um erro ou abuso.
A discussão deixa de ser apenas:
“o modelo sabe cibersegurança?”
E passa a ser:
“quanto trabalho podemos permitir que ele execute sozinho?”
O diferencial pode ser quem encontra primeiro
OpenAI, Google e Anthropic estão chegando a essa fronteira por caminhos diferentes.
Astra demonstra até onde capacidades ofensivas podem chegar em avaliações controladas.
Gemini 3.8 Flash Cyber mostra como descoberta e correção podem virar tarefas de agentes defensivos.
Fable e Mythos mostram que uma mesma inteligência pode receber níveis diferentes de liberdade de acordo com o usuário e o risco.
Os três movimentos apontam para algo maior.
A inteligência artificial está começando a trabalhar dentro da cibersegurança, e não apenas conversar sobre ela.
Para defensores, isso pode significar encontrar uma vulnerabilidade antes que um criminoso encontre.
Para atacantes, capacidades semelhantes também podem reduzir barreiras técnicas.
Por isso a próxima disputa não será apenas por modelos mais inteligentes.
Será por modelos capazes de agir — sem perdermos o controle sobre onde, como e para quem eles podem agir.
A IA está acelerando a descoberta.
A resposta precisa acelerar junto.
E, nessa nova fase, provavelmente continuará existindo uma pergunta acima de todas:
quem encontra a falha primeiro?
O método é o protagonista. A ferramenta é o veículo.
Valiant Tecnologia — promovendo evolução consciente.

