Um agente de inteligência artificial não precisa usar o modelo mais caro em todas as etapas.
Um sistema mais capaz pode planejar o trabalho, decidir prioridades e avaliar o resultado. Tarefas estreitas, repetitivas e bem definidas podem ser entregues a um modelo menor. Essa divisão começa a ganhar importância porque agentes consomem tokens várias vezes durante uma única execução.
O Claude Haiku 5.5 foi lançado pela Anthropic para ocupar justamente essa camada: velocidade e baixo custo em resumo, classificação, busca, compactação de contexto, uso de ferramentas e trabalho como subagente.
A novidade não prova que agentes ficaram baratos. Ela mostra uma forma mais disciplinada de decidir onde gastar capacidade.
O que é o Claude Haiku 5.5
O Haiku 5.5 é o menor modelo da família Claude 5.5. A Anthropic o apresenta como seu modelo pequeno mais rápido e capaz até agora, voltado a cargas de alto volume e sensíveis à latência.
Entre os usos indicados pela empresa estão:
- resumos e classificação de documentos;
- extração de informações;
- consultas a bancos de dados;
- compactação de contexto;
- atendimento em tempo real;
- tarefas específicas de programação;
- automação de navegador e computador;
- subtarefas delegadas por modelos maiores.
O modelo está disponível no Claude.ai, Claude Code, Claude Platform, Amazon Web Services, Google Cloud e Microsoft Azure/Foundry. Na API, o identificador é claude-haiku-5-5.
Quanto custa o Haiku 5.5
O preço muda conforme o tamanho do prompt. Para solicitações de até 100 mil tokens, os valores são muito menores que os do Haiku 4.5. Acima desse limite, a tarifa sobe.
| Modelo ou faixa | Entrada por 1 milhão de tokens | Saída por 1 milhão de tokens |
|---|---|---|
| Haiku 5.5 até 100 mil tokens | US$ 0,10 | US$ 0,50 |
| Haiku 5.5 acima de 100 mil tokens | US$ 0,50 | US$ 2,50 |
| Haiku 4.5 | US$ 1,00 | US$ 5,00 |
| Sonnet 5.5 | US$ 2,00 | US$ 10,00 |
A Anthropic estima que o Haiku 5.5 custe, em média, cerca de 75% menos por tarefa que o Haiku 4.5. A redução nominal é de 90% para solicitações de até 100 mil tokens e 50% acima disso.
Essas porcentagens exigem contexto. A empresa também mudou o tokenizador, e o Haiku 5.5 pode usar uma quantidade diferente de tokens para concluir o mesmo trabalho. Por isso, comparar apenas a tabela de preços não basta.
Preço por token não é custo por tarefa concluída
Um modelo barato pode sair caro quando erra, repete chamadas, utiliza contexto demais ou exige revisão intensa. Um modelo mais caro pode terminar uma tarefa complexa em menos tentativas.
O custo real de um agente depende de vários fatores:
- quantas vezes o modelo é chamado;
- quanto contexto é enviado em cada chamada;
- quantas ferramentas são utilizadas;
- quantas tentativas falham;
- quanto conteúdo é recuperado do cache;
- quanto trabalho humano é necessário para conferir e corrigir;
- qual é o valor da tarefa concluída.
Essa distinção evita a conclusão apressada de que trocar todos os modelos por uma opção menor reduzirá a conta sem afetar o resultado.
Modelo coordenador e modelo executor
A utilidade mais interessante do Haiku 5.5 aparece quando o trabalho é dividido por função.
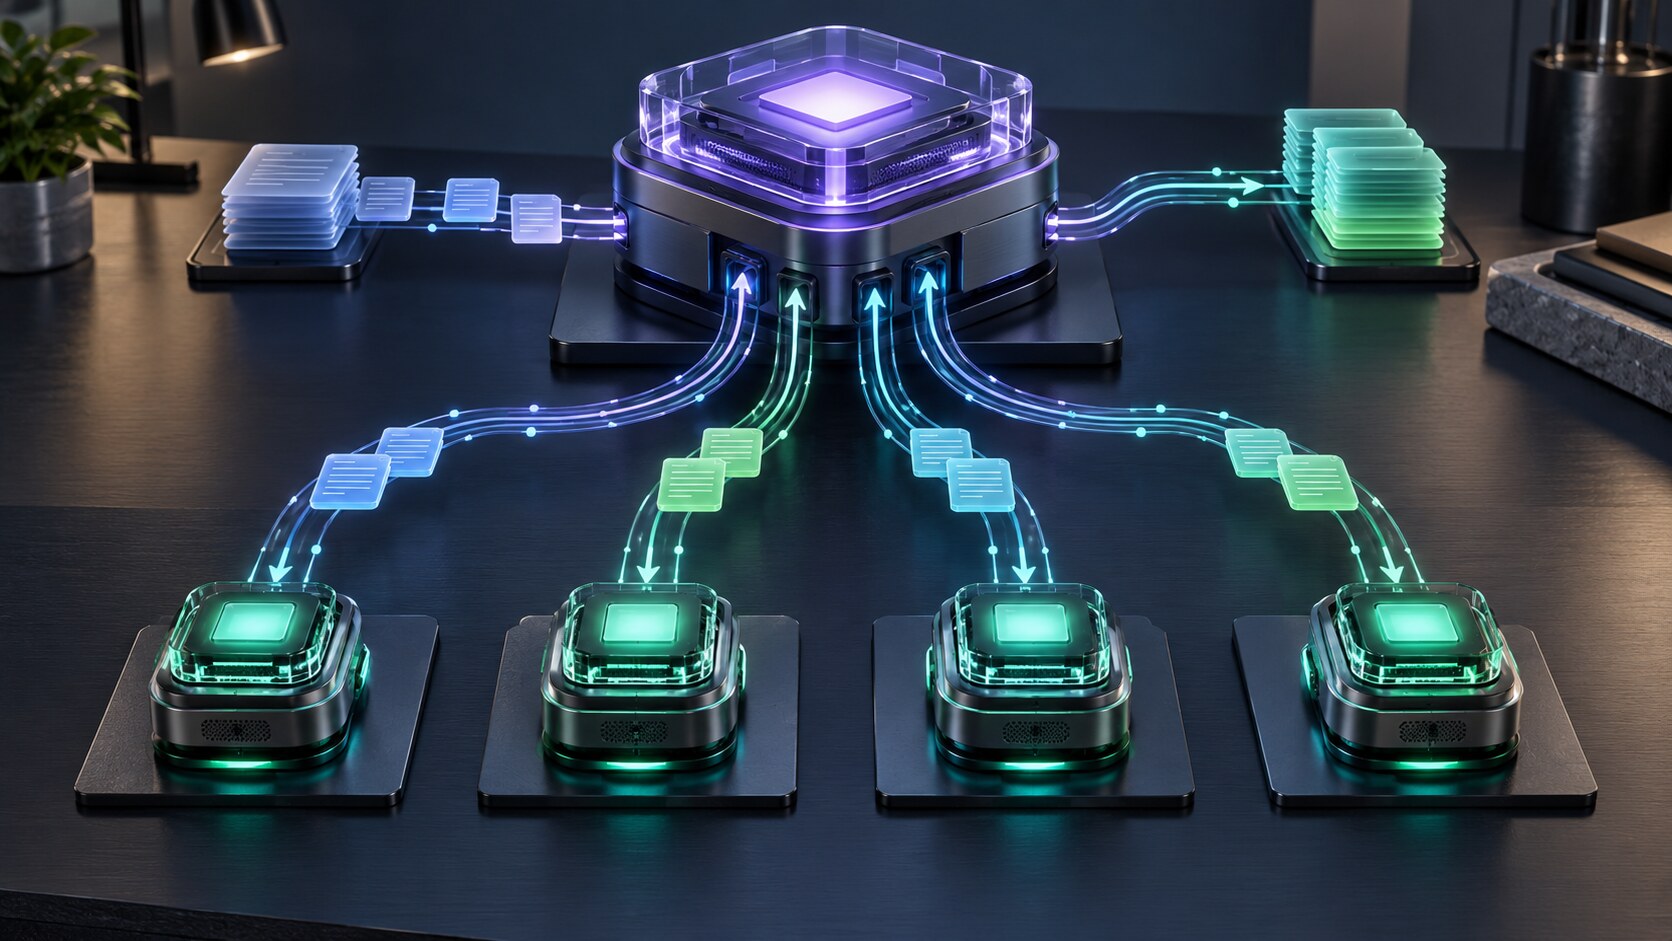
Imagine um agente encarregado de analisar centenas de documentos e preparar um relatório. Um modelo maior pode:
- interpretar o objetivo;
- definir quais informações devem ser localizadas;
- criar critérios de qualidade;
- distribuir subtarefas;
- comparar os resultados;
- redigir ou aprovar a conclusão.
Enquanto isso, instâncias do Haiku podem procurar campos específicos, resumir trechos, classificar arquivos ou extrair números em paralelo.
Essa arquitetura não cria uma hierarquia inteligente por conta própria. Alguém ainda precisa definir quais tarefas podem ser delegadas, quais ferramentas cada subagente pode usar e quando uma revisão mais cuidadosa é obrigatória.
Quando um modelo menor faz sentido
O Haiku tende a ser mais adequado quando a tarefa tem objetivo estreito, resposta verificável e baixo custo de correção.
- Classificar solicitações em categorias conhecidas.
- Extrair campos de documentos padronizados.
- Resumir textos para uma etapa posterior.
- Preparar uma busca antes da análise principal.
- Compactar uma conversa ou histórico.
- Executar pequenas alterações de código bem delimitadas.
- Preencher formulários com dados já validados.
Em todos esses casos, é possível definir com clareza o que deve entrar, qual resultado é esperado e como conferir se a tarefa foi concluída.
Quando economizar no modelo pode sair caro
Tarefas ambíguas, sensíveis ou difíceis de verificar exigem mais cautela.
Um modelo menor não deve receber automaticamente a decisão final quando o trabalho envolve:
- interpretação jurídica, médica ou financeira;
- conflitos entre fontes;
- decisões difíceis de desfazer;
- acesso amplo a dados ou sistemas;
- planejamento com muitas dependências;
- avaliação subjetiva de qualidade;
- riscos de segurança.
Nessas situações, reduzir o preço da inferência pode aumentar o custo de falhas, supervisão e retrabalho.
A Anthropic também reduziu o custo do Sonnet 5.5
O lançamento do Haiku veio acompanhado de outra mudança. A Anthropic cortou pela metade o preço das leituras de cache do Sonnet 5.5, de US$ 0,20 para US$ 0,10 por milhão de tokens.
Como o cache representa parte relevante do consumo em trabalhos de programação e agentes, a empresa estima aproximadamente 20% de economia na maioria dessas cargas. É uma estimativa da própria Anthropic e pode variar bastante conforme o fluxo.
A empresa também anunciou créditos mensais de API para assinantes Max e Team, destinados à criação de ferramentas e agentes na Claude Platform. Disponibilidade regional e condições do benefício precisam ser conferidas na conta antes de qualquer planejamento de custo.
O que os benchmarks mostram e o que não mostram
A Anthropic publicou resultados nos quais o Haiku 5.5 supera o Haiku 4.5 em uso de computador, programação com agentes, raciocínio visual e trabalho de conhecimento.
Esses testes ajudam a entender a posição pretendida para o modelo, mas foram organizados e divulgados pela própria fabricante. Eles não demonstram que o Haiku será a melhor escolha em qualquer aplicação real.
Antes de substituir um modelo, equipes precisam testar suas próprias tarefas, medir taxa de acerto, latência, custo total e quantidade de intervenção humana.
A pergunta correta não é “qual modelo venceu mais benchmarks?”. É “qual configuração conclui este trabalho com qualidade suficiente, custo aceitável e risco controlado?”.
O custo dos agentes já era uma questão antes do Haiku 5.5
A Valiant mostrou anteriormente que executar vários agentes em paralelo multiplica trabalho computacional e custo. Também explicamos por que ferramentas, permissões e supervisão fazem parte da arquitetura de um agente.
O Haiku 5.5 acrescenta uma camada econômica a essa discussão. Além de perguntar quantos agentes executar, passa a ser necessário escolher qual nível de modelo cada etapa merece.
Nem toda tarefa exige o melhor modelo disponível. Nem toda economia de tokens compensa uma queda de qualidade.
Uma regra prática para escolher
Comece com a solução mais simples que consiga cumprir a tarefa com segurança.
- Defina o resultado esperado.
- Separe planejamento, execução e revisão.
- Identifique tarefas repetitivas e verificáveis.
- Teste o modelo menor nessas etapas.
- Meça custo por tarefa concluída, não apenas por token.
- Reserve modelos maiores e aprovação humana para decisões mais difíceis.
A economia não vem de usar o modelo mais barato em tudo. Vem de parar de usar capacidade cara onde ela não acrescenta valor.